Как обезличить документ
Договор нужно отправить подрядчику, выгрузку — в нейросеть, реестр — в аудит. Во всех трёх случаях внутри лежат чужие паспорта, ИНН и телефоны, которых там быть не должно. Ниже — как обезличить документ так, чтобы файл остался рабочим, а данные из него исчезли. Механика у Word и PDF разная, и упирается она в носитель, а не в видимый текст: у файла есть слои, которых не видно на экране.
Что значит «обезличить документ»
Обезличить документ — значит заменить в нём сведения, по которым можно определить человека, и отдать файл в прежнем формате. Не «убрать пару страниц», не «переименовать колонку ФИО» и не «отправить картинкой вместо PDF» — всё это лишь прячет данные, а сам файл ломает.
152-ФЗ в статье 3 формулирует аккуратно: обезличенные данные — те, по которым без дополнительной информации нельзя определить, кому они принадлежат. Слова «без дополнительной» здесь ключевые. Если ключ соответствия у вас остался, данные по-прежнему персональные — просто вы контролируете доступ к ключу. Это и есть разница между обезличиванием и анонимизацией: анонимизацию отменить нельзя, а обезличенный документ можно вернуть к исходному виду, если у вас есть чем.
Почему нельзя просто затереть фамилии руками
Потому что данных в документе больше, чем видно на первом экране.
Возьмите обычный договор. Паспорт в реквизитах. ИНН в шапке. Расчётный счёт в разделе оплаты. Телефон в блоке контактов. Тот же телефон — в колонтитуле, который вы не листали. СНИЛС — в приложении с копией. Дата рождения — внутри номера, который выглядит как обычная строка цифр.
Ручная правка ломается на трёх вещах. Первое: человек видит то, что помнит, и пропускает неочевидное — адрес электронной почты в сноске, номер счёта в таблице на третьем листе. Второе: заменив значение на «Иванов И.», легко забыть, что тот же Иванов упомянут в комментарии к ячейке. Третье и самое неприятное: замена руками не проверяется. Отправили — и надеетесь.
Отсюда правило: если обезличивание делается регулярно, его должен делать инструмент. Руками имеет смысл чистить один документ на три страницы, и то с чек-листом.
Данные в файле лежат не только в тексте
Почищенный текст — это ещё не чистый файл. В Word есть встроенный инструмент, который проверяет и удаляет служебные слои: примечания, исправления и версии, свойства документа и персональные данные (метаданные, свойства SharePoint, настраиваемые свойства), пользовательские XML-данные, колонтитулы и подложки, скрытое содержимое и скрытый текст.
Открывается так: Файл → Сведения → Поиск проблем → Инспектор документов.
Ограничение, которое легко пропустить. Автоматическое удаление скрытых данных не работает в подписанных, защищённых документах и документах с IRM. Инспектор нужно запускать до подписи и до применения IRM, иначе он честно откажется.
Отдельно проверьте свойства файла. Автор и организация видны в «Сведениях», и имя составителя может пережить все правки текста. У .docx это вообще zip-контейнер: по стандарту Office Open XML (ECMA-376, часть 2 «Open Packaging Conventions», он же ISO/IEC 29500) тело документа и служебные части лежат внутри пакета отдельно, и в свойствах остаётся, кто файл создал и кто последним сохранял. Поиск по тексту туда не заглядывает.
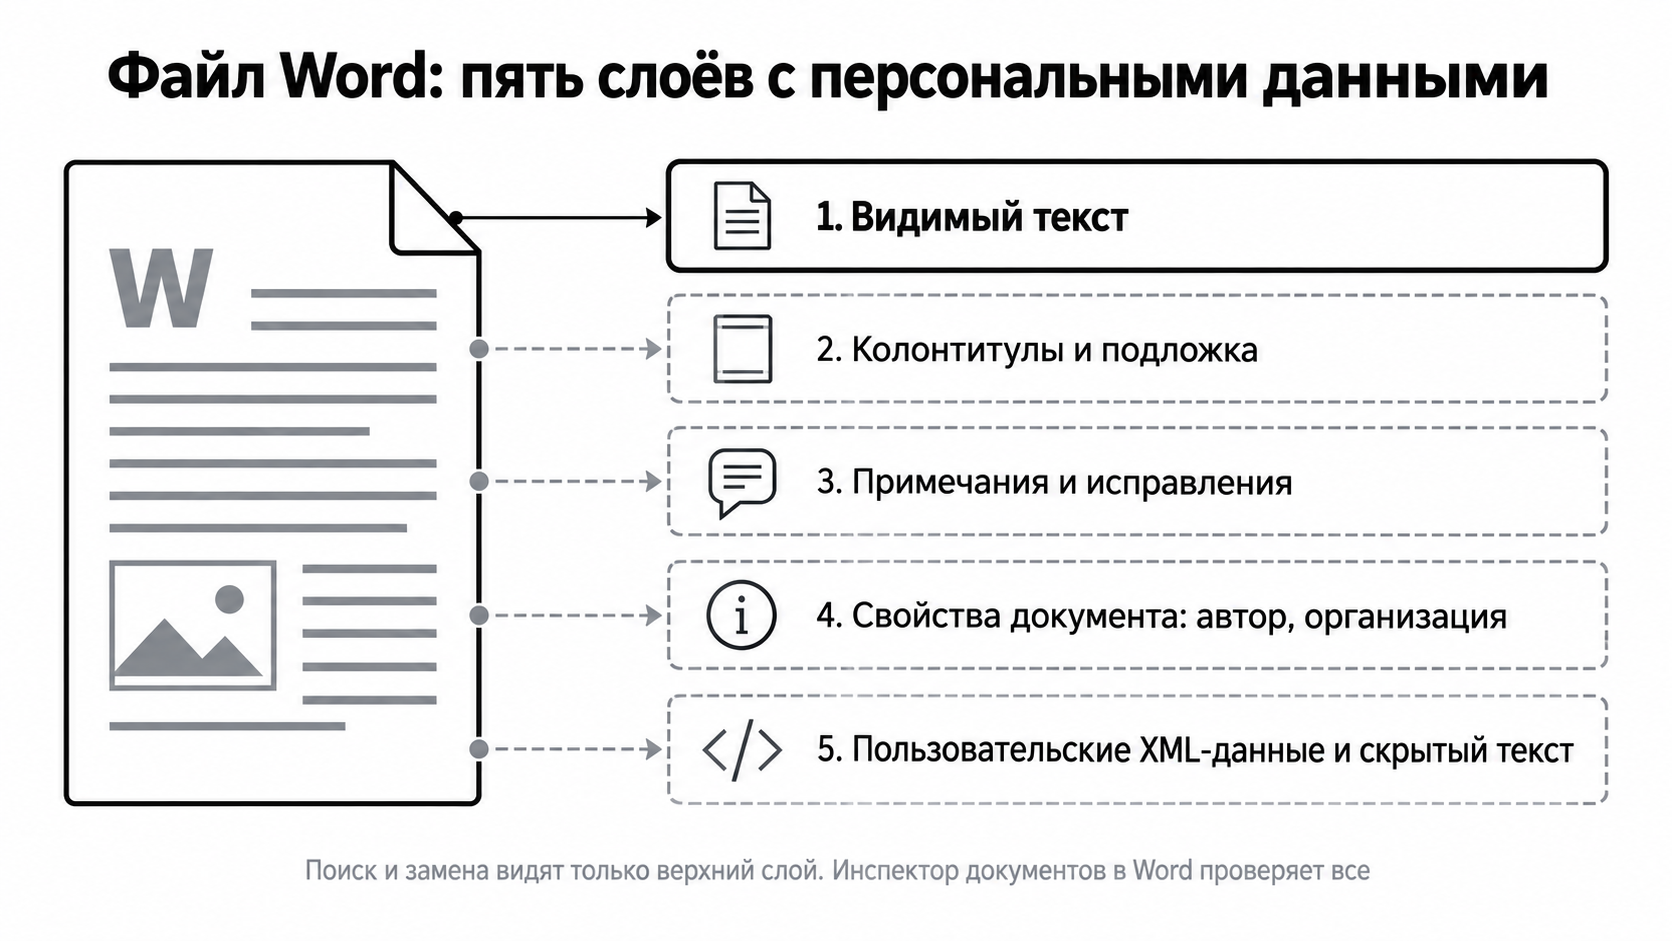
Комментарии коллег, отслеживаемые исправления и удалённый текст тоже остаются в документе, даже если на экране их не видно. Примите все правки и удалите комментарии перед обезличиванием, иначе в файл уедет полная история обсуждения с фамилиями.
Что именно нужно убрать
Список для документа из российской практики выглядит так:
- паспорт РФ — серия и номер, включая варианты с пробелами, дефисами и разделителями;
- ИНН, СНИЛС, ОГРН и ОГРНИП — их стоит искать с проверкой контрольной суммы;
- номера банковских карт, срок действия и CVV;
- расчётные счета, БИК, КПП;
- телефоны и адреса электронной почты;
- адреса и даты рождения, если они позволяют найти человека.
Проверка контрольной суммы — не педантизм. ИНН из договора и ИНН, набранный с опечаткой, выглядят одинаково, и без проверки инструмент замаскирует оба: один по делу, второй — выдумав персональные данные там, где их нет. А ложная тревога в документе на 80 страниц стоит дороже, чем время на её поиск.
Чем заменить: два способа, и выбор не косметический
Заменить можно двумя способами, и они означают разное.
Необратимо. Значение вырезается, на его месте остаётся метка вида [REMOVED:RU_PASSPORT]. Исходного значения после такой замены нет ни в документе, ни на сервере. Это подходит для всего, что уходит наружу и возвращаться не должно: в нейросеть, подрядчику, в архив.
Обратимо. Значение шифруется и уходит в отдельное хранилище, а в тексте остаётся токен вида [VAULT:mgv_…]. Документ правит человек, реквизиты должны вернуться на место — тогда нужен этот вариант. Токен раскрывается по ключу, и это ровно метод введения идентификаторов, который Роскомнадзор описывает в приказе № 140 от 19.06.2025.
Что выбрать? Смотрите на судьбу документа. Если он уходит за периметр и не возвращается — необратимо. Если документ должен пережить правку и вернуться к вам с живыми реквизитами — обратимо. Хранить обратимость «на всякий случай» смысла нет: каждое сохранённое значение — это ещё одна копия персональных данных, за которую вы отвечаете.
Нормативная гигиена: приказ № 140
С 1 сентября 2025 года действует приказ Роскомнадзора от 19.06.2025 № 140. До него обезличивание в России жило на приказе № 996 от 05.09.2013, и на него до сих пор ссылаются во многих подборках в интернете. № 996 утратил силу: если в чек-листе у вас стоит именно он, чек-лист пора переписать.
Методов в приказе пять, и они перечислены в приложении № 2: введение идентификаторов, изменение состава или семантики данных, перемешивание, декомпозиция и преобразование массива. Применять их можно по отдельности или в совокупности — приказ не требует выбрать один и жить с ним.
Практический пункт здесь один, и он про хранение. Метод введения идентификаторов — это замена значений на коды. К приказу прилагается требование: ключ, который позволяет сопоставить идентификаторы с исходными данными, хранится отдельно от массива и третьим лицам не передаётся (приложение № 2, пункт 3). Положили таблицу «код → фамилия» в ту же папку, где обезличенный документ, и обезличивания нет. Есть кодировка, которая раскрывается за минуту.
Дальше начинается работа оператора, а не сервиса: определить состав данных под свою цель, оценить, хватает ли выбранного метода, вести локальные акты. Формально это пункты чек-листа. По сути — ответ на вопрос «достаточно ли я обезличил», и спросить больше не у кого.
Механика: почему закраска PDF не работает
Самый частый способ в просмотрщике: нарисовать чёрный прямоугольник поверх фамилии и сохранить. На экране данных нет. В файле они на месте: текстовый слой под прямоугольником остаётся, его спокойно выделяют и копируют. Прямоугольник ничего не удаляет, он прячет слой под собой.
Это не только мои наблюдения. В руководстве по редактированию PDF суда США (Court of Federal Claims) сказано прямо: чёрный прямоугольник «лишь прячет данные», и любой может скопировать его, вставить в текстовый документ — информация под прямоугольником появится (PDF File Redaction Best Practices, перевод мой). Соседнее руководство, у District of Minnesota, повторяет ту же мысль про чёрные плашки в текстовом редакторе (Best Practices: Redaction of Information). Это практика из судебных руководств США, а не норма российского права, но механика PDF от юрисдикции не зависит.
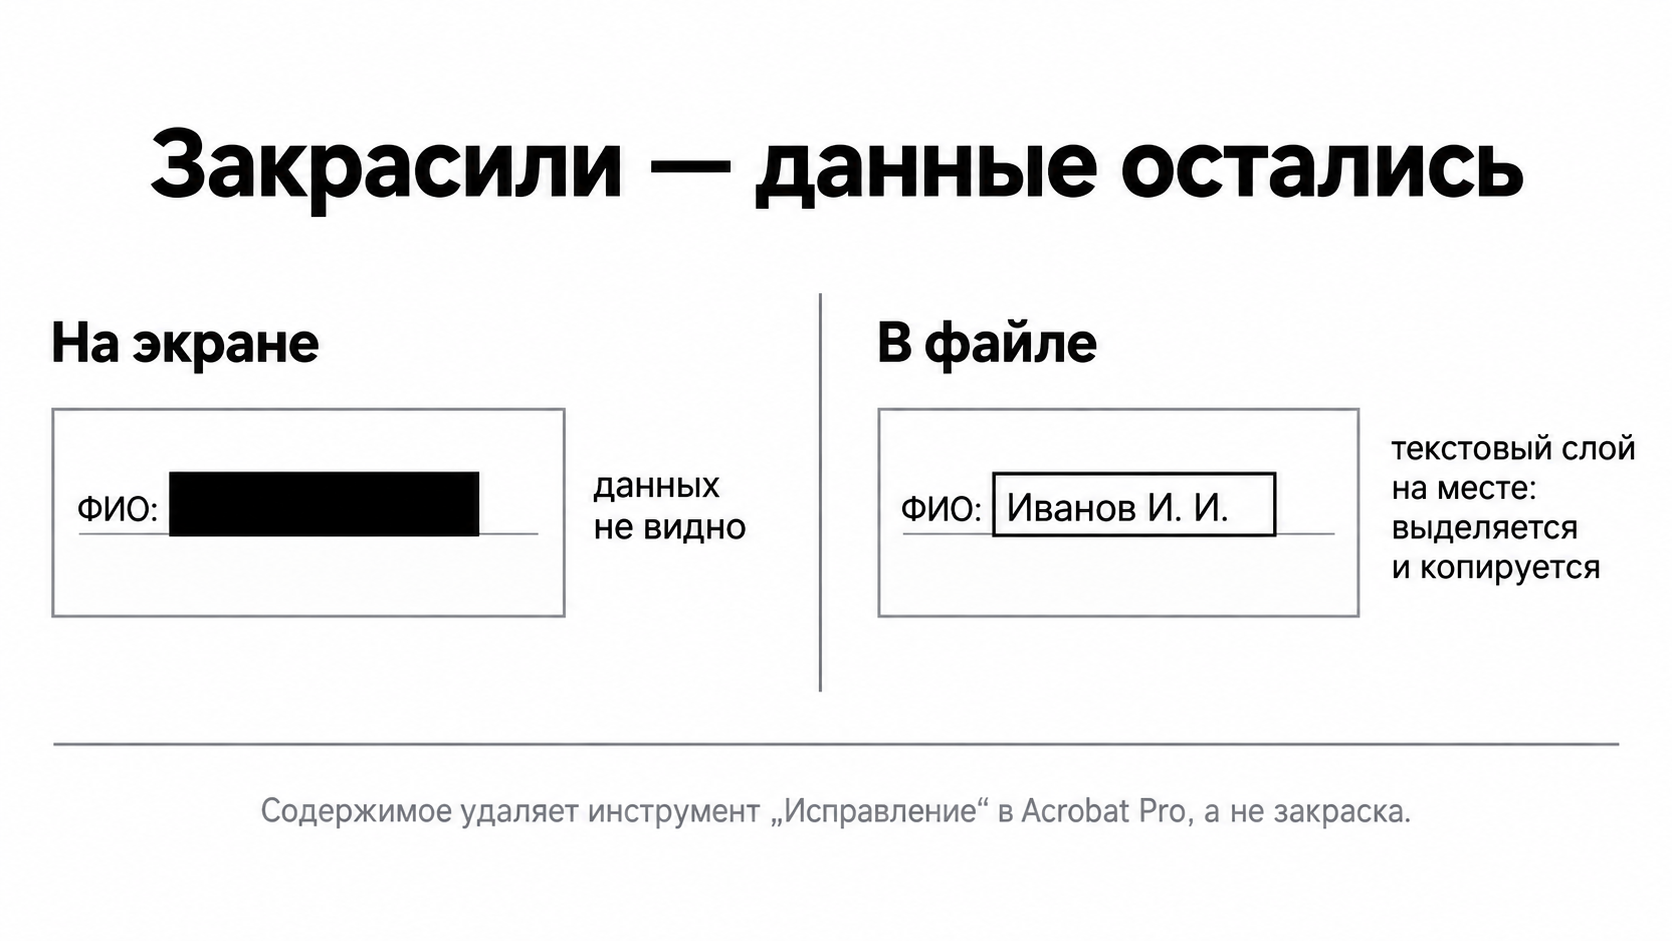
Чистит PDF пересборка, а не закраска. Данные вырезаются из содержимого страницы, после чего файл собирается заново и текстового слоя в нём уже нет. Цена честная: поиск по тексту в таком файле работать не будет. Скрыть данные и удалить их — разные операции, и вторая всегда что-то ломает.
Пошагово: как обезличить документ
- Определите, что именно уходит наружу. Если файл идёт в нейросеть или подрядчику — необратимая замена. Если файл вернётся к вам для правки — обратимая.
- Загрузите файл в сервис. Поддерживаются TXT, DOCX, XLSX, CSV и PDF, а также изображения PNG, JPG, JPEG, TIFF, TIF и BMP — с картинок текст снимается распознаванием. Старые
.doc, ODT и RTF не принимаются: сначала сохраните документ в DOCX. - Посмотрите на находки, а не только на результат. Список найденного — единственное место, где видно, что инструмент действительно нашёл, а что пропустил. Ноль находок в договоре с реквизитами — сигнал разобраться, а не расслабиться.
- Проверьте результат глазами на одном абзаце. Достаточно убедиться, что структура цела: таблицы на месте, колонтитулы не поехали, текст читается.
- Скачайте файл и отправьте его. Ссылка на результат живёт недолго — скачивайте сразу.
Что получится на выходе
Тут начинаются различия между форматами, и о них честнее знать заранее.
DOCX и XLSX пересобираются как настоящие документы: структура, стили и листы остаются, меняется только содержимое. Это самый предсказуемый вариант.
PDF отдаётся с затиранием: страницы рендерятся в изображения, найденные данные закрываются чёрными плашками. Данные из содержимого при этом вырезаны, поэтому текстового слоя в файле больше нет — поиск по тексту работать не будет. Если PDF был чистым, вернётся исходный файл без изменений.
TXT и CSV отдаются текстом с заменами.
Изображения — отдельный случай: текст с картинки распознаётся и найденные данные попадают в отчёт, но маскированного изображения сервис не собирает. Если нужен именно обезличенный скан, его придётся собирать отдельно.
Способы обезличить файл: вручную, скриптом, сервисом
Один документ на две страницы и поток выгрузок — разные задачи, и инструмент под них разный.
Вручную. Ctrl+H, инспектор документов, глазами по всем страницам. Хорошо работает на одиночных файлах, когда документ на две страницы и вы знаете его наизусть. На потоке ломается, причём причина скучная: устают глаза.
Скриптом. Python, регулярные выражения, проверка контрольных сумм. ИНН и СНИЛС сверяются по контрольной сумме, номер карты по алгоритму Луна. Арифметика резко срезает ложные срабатывания: регулярка может соврать, контрольная сумма почти нет. Сильная сторона скрипта — повторяемость. Правило написали один раз, дальше оно применяется к сотне файлов одинаково. Слабая сторона та же самая: скрипт обезличивает ровно то, что вы описали в правилах. Фамилию в косвенном падеже он не увидит, скан без OCR не увидит вообще.
Сервисом. Загрузка файла, отчёт по категориям найденного, маскирование, скачивание. Отчёт тут не украшение: он показывает, что инструмент нашёл, а что нет. На замере 09.10.2026 recall 99,78 %, precision 99,92 % на корпусе из 1 473 записей и 40 категорий, профиль без NER (страница метрик). Считайте это свойством корпуса, а не гарантией на вашем скане: на живых документах числа будут другими. Документ до 500 страниц сервис примет, но на плотном или сканированном PDF разбор может не уложиться в бюджет времени. Тогда в отчёте появится ошибка, а не результат: сервис либо отдаёт файл, либо помечает его как непроверенный и не даёт скачать.
| Критерий | Вручную | Скриптом | Сервисом |
|---|---|---|---|
| Время | Минуты на документ, на потоке растёт линейно | Часы на правила один раз, потом секунды на файл | Секунды-минуты: загрузка, отчёт, маскирование, скачивание |
| Риск ошибки человека | Высокий: забыли метаданные, скрытый текст, колонтитул, абзац на 47-й странице | Низкий там, где правило описано. Чего в правилах нет, того скрипт не увидит | Низкий по категориям из конфига: на замере одна ложная находка на 1 385 подтверждённых |
| Объёмный документ: PDF до 500 страниц | Почти нереально: 500 страниц поиска-замены и перечитывания | Рабочий вариант, если правила покрывают документ. Скан без OCR не обезличится | Документ до 500 страниц сервис примет, но на плотном или сканированном PDF разбор может не уложиться в бюджет времени: файл помечается как непроверенный, и скачать результат нельзя |
Моё мнение короткое. Один документ на две страницы: хватит поиска-замены и инспектора, сервис тут оверкилл. Поток документов: ручной путь ломается первым, дальше либо скрипт со своими правилами, либо сервис. Личную ответственность за результат никто из троих не отменяет: проверить итог всё равно придётся вам.
Где способ ломается
Честный список — он короче, чем принято писать в статьях про обезличивание.
Картинки внутри документа. Если в DOCX или XLSX вставлены изображения, пересборка их не проверяет: скан паспорта, вложенный в договор картинкой, остался бы в «обезличенном» файле как есть. Поэтому такой файл помечается как непроверенный, и скачать результат нельзя. Отказ здесь лучше ложного «чисто».
Длинные сканы. У разбора есть бюджет времени на файл. Многостраничный скан может в него не влезть — тогда файл помечается ошибкой, а не отдаётся частично проверенным. Это ограничение известно и в работе.
Нестандартные форматы реквизитов. Реквизит, переписанный необычно, может не найтись. Контрольные суммы и контекст снижают риск, но не обнуляют его.
Формат вне списка. Старый .doc, ODT и RTF не принимаются: сначала сохраните документ в DOCX.
И главное ограничение, которое не про код: обезличивание чистит файл, а не людей. Сотрудник, который помнит паспорт клиента, обойдёт любой фильтр — для такого сценария нужны организационные меры, а не регулярные выражения.
Если документов много
Обезличивать по одному файлу имеет смысл, пока их три. Когда речь о регулярном потоке — выгрузках из CRM, пачках договоров, — появляются два варианта. Первый: загружать пачкой, если сервис это умеет. Второй: подключить маскирование туда, где документ рождается, — через API, чтобы данные не успевали уехать наружу в исходном виде. Второй вариант дороже на старте и дешевле в эксплуатации: он не зависит от того, вспомнил ли сотрудник про проверку.
Какой бы путь вы ни выбрали, проверьте результат на одном реальном документе до того, как поставите процесс на поток. Один тестовый файл дешевле одной отправленной не туда выгрузки.
Не является юридической консультацией. Проверяйте актуальную редакцию 152-ФЗ.
Не является юридической консультацией. Проверяйте актуальную редакцию 152-ФЗ.